Cómo copiar el texto de un PDF
Entra en tutoriolab.com/pdf/es, pulsa Sacar el texto, mete el PDF y dale al botón. Se descarga un .txt con todo lo escrito, hoja por hoja. Si el PDF es un escaneo no saldrá casi nada: ahí no hay texto, hay una imagen de un texto.
Sacar todo el texto de un PDF de golpe.
Entra en tutoriolab.com/pdf/es
Entra en tutoriolab.com barra pdf barra es. Lo tienes arriba a la izquierda y el primero en la descripción. Aquí hay veinte herramientas para PDF, y la que buscamos es esta: Sacar el texto.
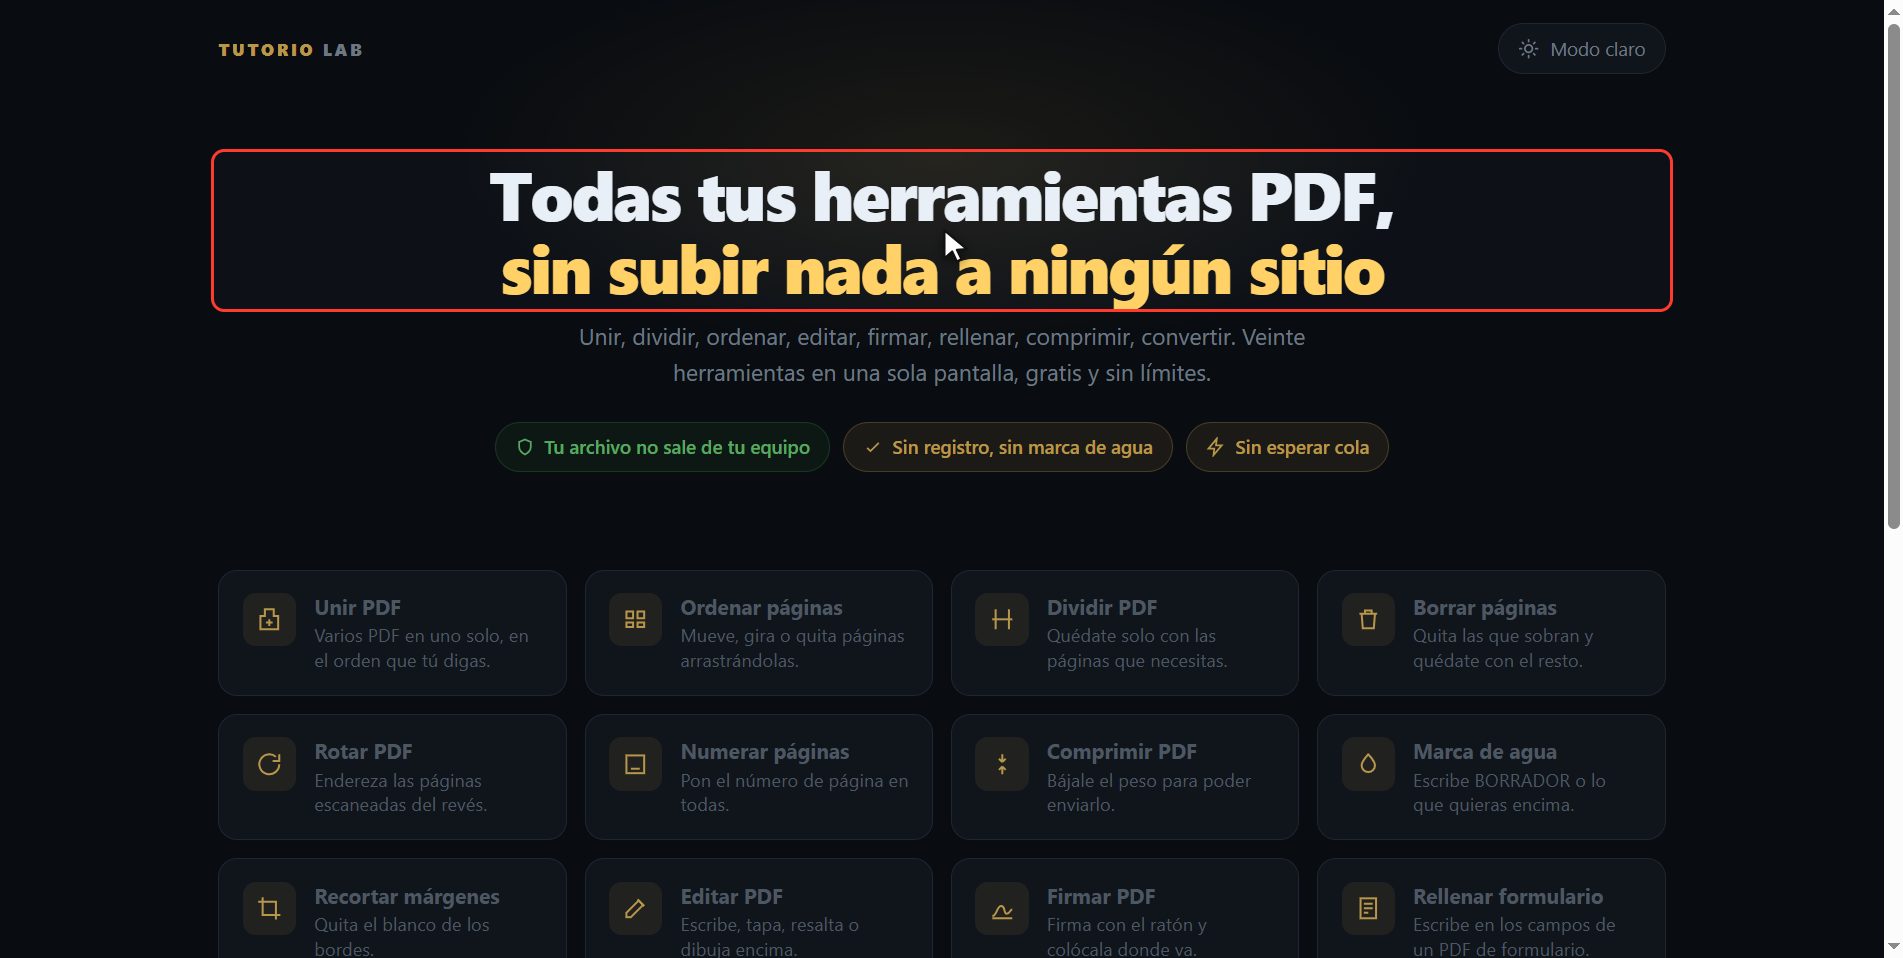
Pulsa "Sacar el texto"
Púlsala. Y ya estás dentro. Esto es todo lo que tiene: un botón para elegir el archivo y el recuadro para soltarlo.
Mete tu PDF
Mete el PDF. Pulsa el botón de seleccionar y elígelo, o arrástralo directamente encima del recuadro. Y en cuanto entra, la página te lo dibuja: no una lista de números, que no te dice nada, sino las hojas del documento.
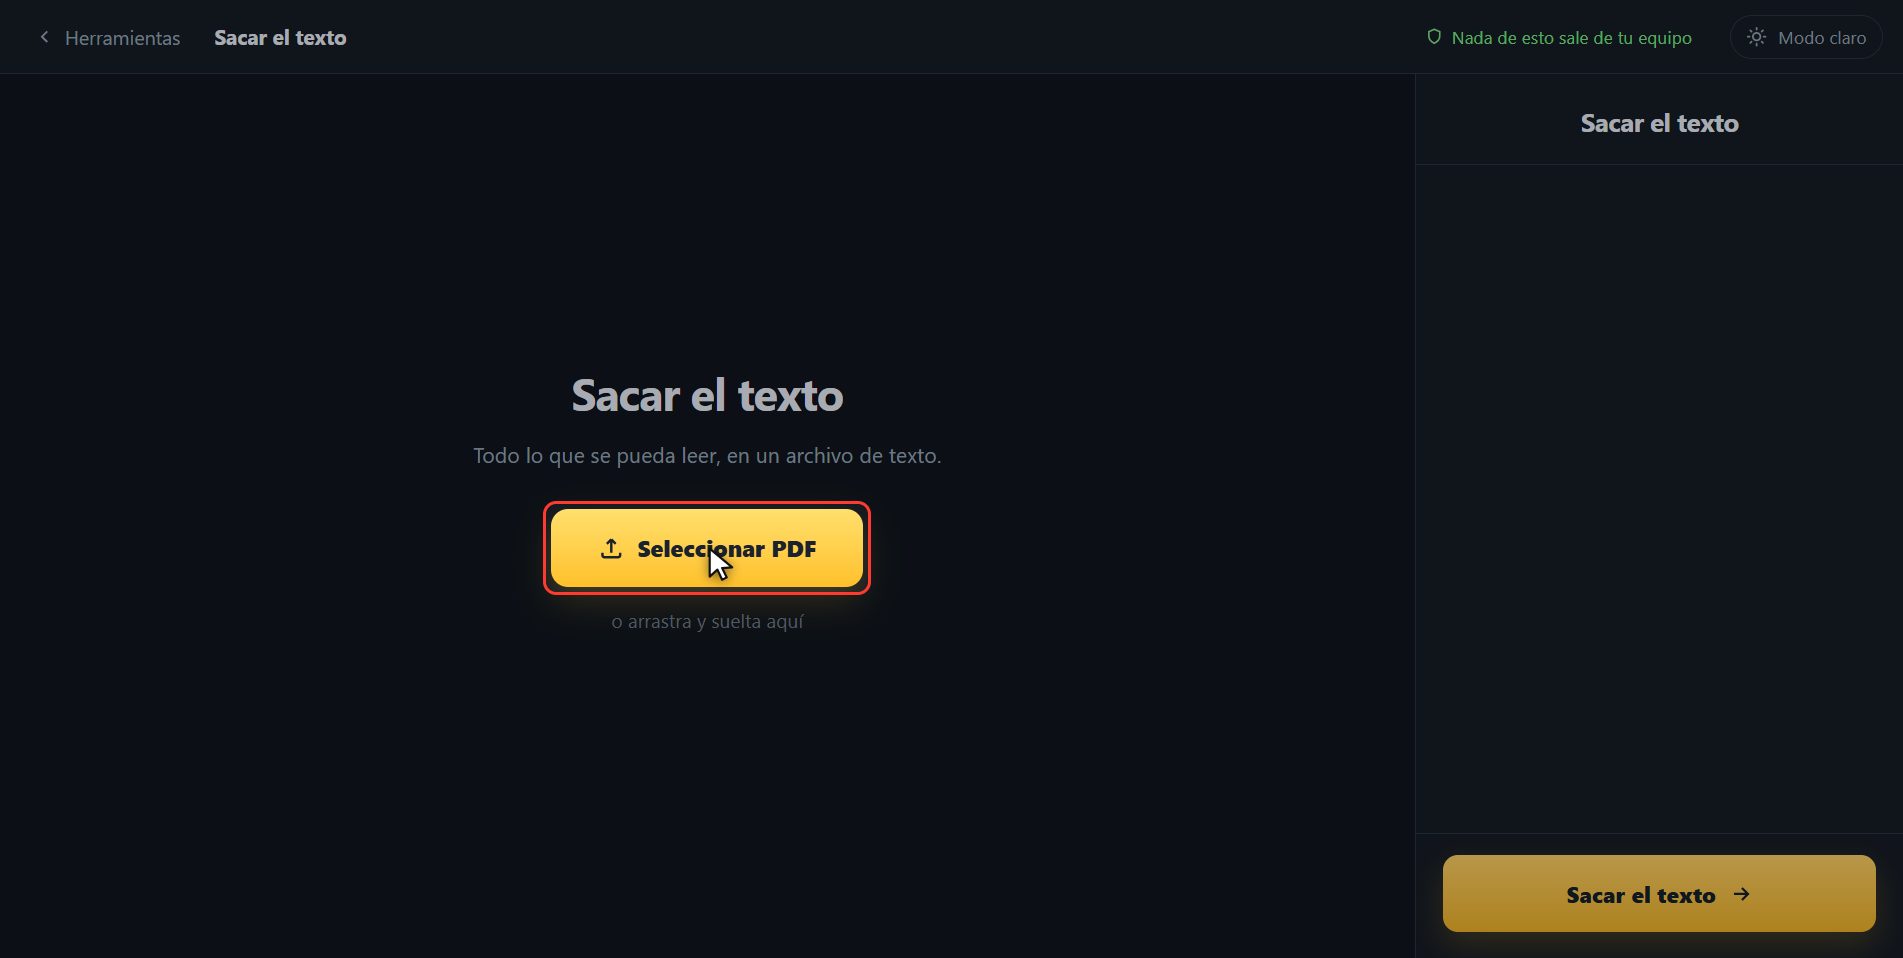
Sácalo
No hay nada que elegir, así que pulsa Sacar el texto. Va hoja por hoja.
Y si tu PDF es un escaneo
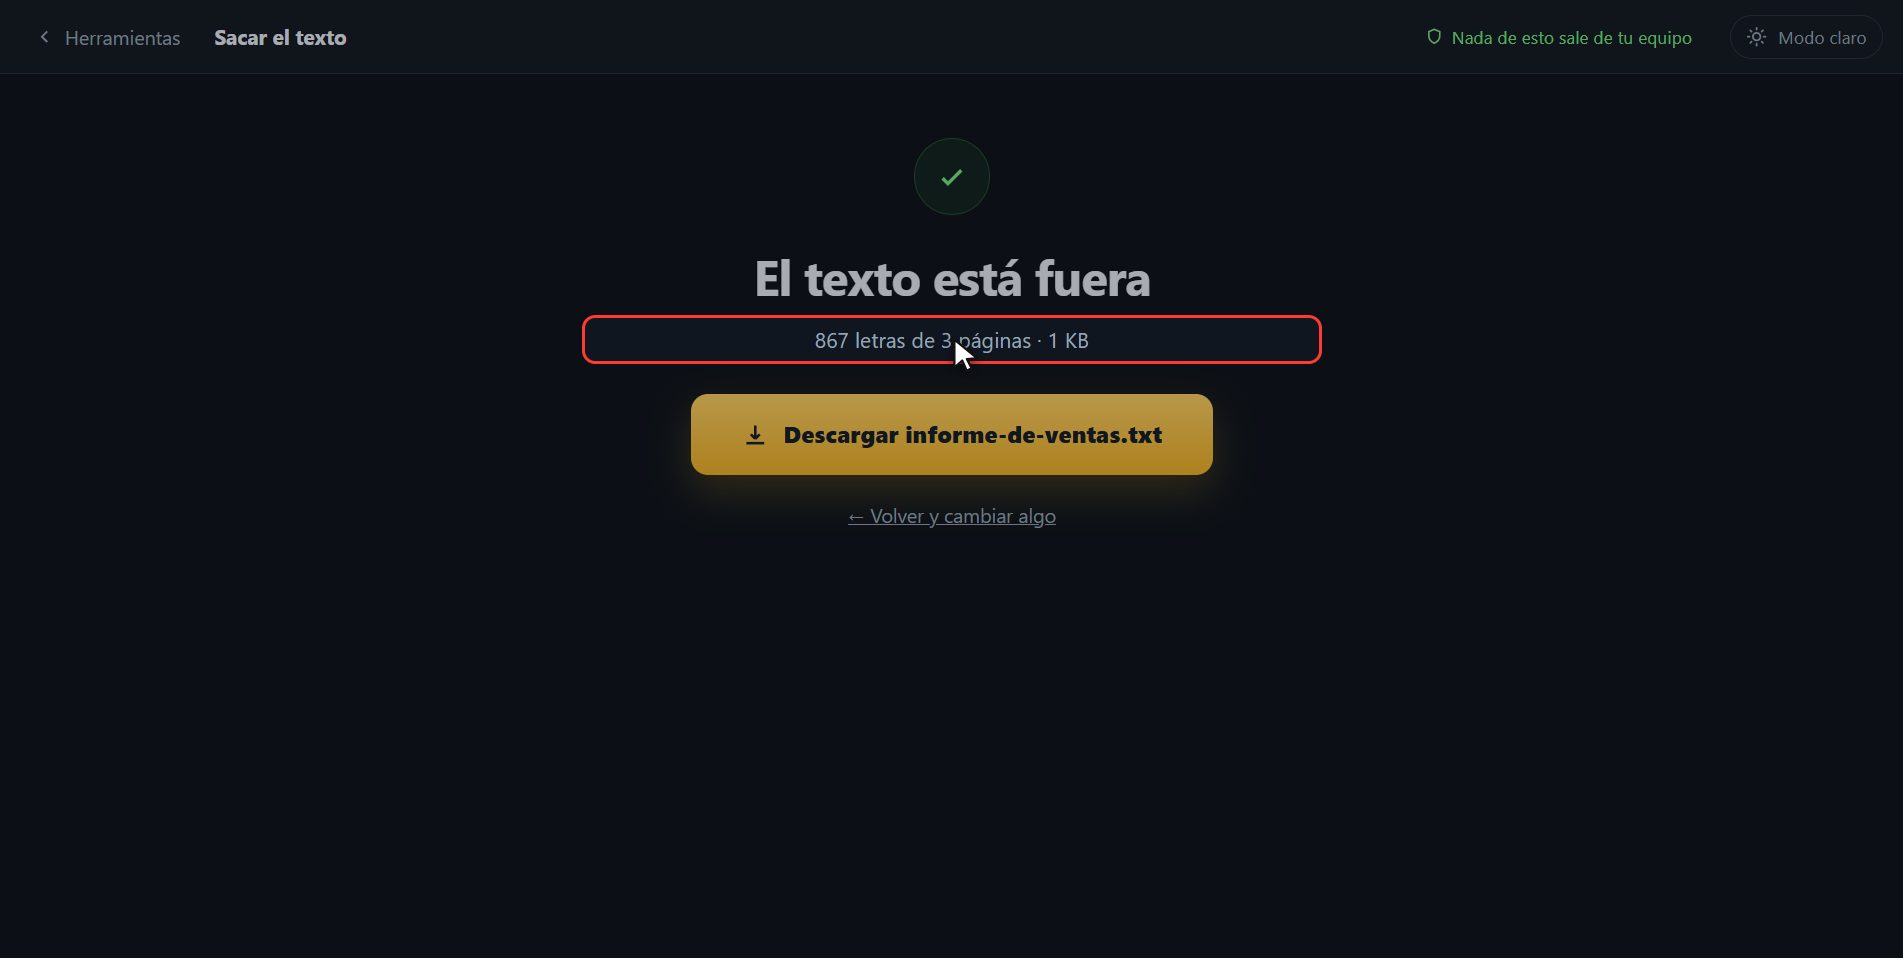
Y ya está: se ha bajado un archivo de texto con todo lo escrito, hoja por hoja, y te dice cuántas letras ha sacado. Lo abres con el bloc de notas y lo pegas donde quieras. Aquí te queda el botón por si tu navegador te lo bloqueó. Y una cosa que te ahorra el disgusto: si tu PDF es un escaneo, esto sacará casi nada, y no es un fallo. En un escaneo no hay letras: hay una foto de unas letras, y para convertirlas en texto hace falta un reconocedor de imágenes, que esta página no lleva. Cuando pasa, la página te lo dice con esas palabras en vez de darte un archivo vacío y dejarte pensando que lo has hecho mal.
Y eso es todo. Si te ha servido, suscríbete y dale a me gusta. El enlace lo tienes arriba y el primero en la descripción. Nos vemos en el siguiente.
Dudas frecuentes
Mi PDF es un escaneo y no saca nada. ¿Por qué?
Porque en un escaneo no hay texto: cada página es una foto. Para convertir esa foto en letras hace falta un reconocedor de texto en imágenes —lo que se llama OCR— y esta página no lo lleva. La herramienta te lo dice cuando detecta que casi no hay letras.
Mi PDF no me deja seleccionar el texto con el ratón.
Eso es una marca que el documento lleva puesta pidiendo al lector que no deje copiar; no cifra nada. Como aquí el texto se lee de dentro del archivo, sale igual. Otra cosa es que el PDF pida contraseña al abrirse: ahí primero hay que quitarla, y para eso hace falta saberla.
¿Mantiene el formato, las tablas y las negritas?
No. Lo que sale es texto limpio, sin tipos de letra ni tablas, separado por páginas. Es lo que sirve para copiar, buscar o pegar en otro sitio y darle formato allí.